
公众号 automate 到自己电脑上:这个开源工作台把"找热点到排版"装成一条流水线
- 工具收集
- 22热度
- 0评论
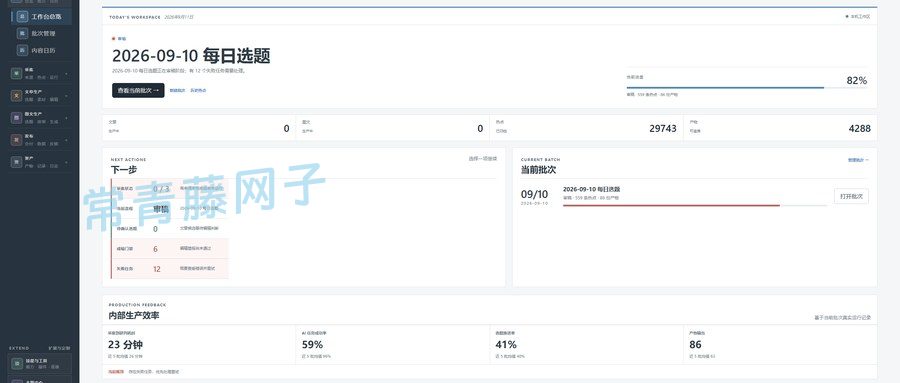
写公众号的人,每天的工作被切成两半:一半在十个网页之间找热点、抄数据、追链接;另一半在编辑器里写稿、排版、传图。中间的选题判断、事实核对、版本管理,全靠脑子记。
GitHub 上有个叫「见字」(wechat-editroom)的开源项目,把这条流水线整个装进了本地桌面应用:找热点、事件研判、编辑决策、写稿、排版、封面、图文,一条链全做完。MIT 协议,2026 年 7 月底建的仓库,到 11 月 19 日已经发了 59 个版本,最新一版就在写稿前一天——更新很勤。
先说清楚它是什么:不是代写神器,是把公众号生产从"十几个网页"收回到"一个本地工作台"的工具。重点讲优点。
一、它把"找热点"做成了工厂里的上料口
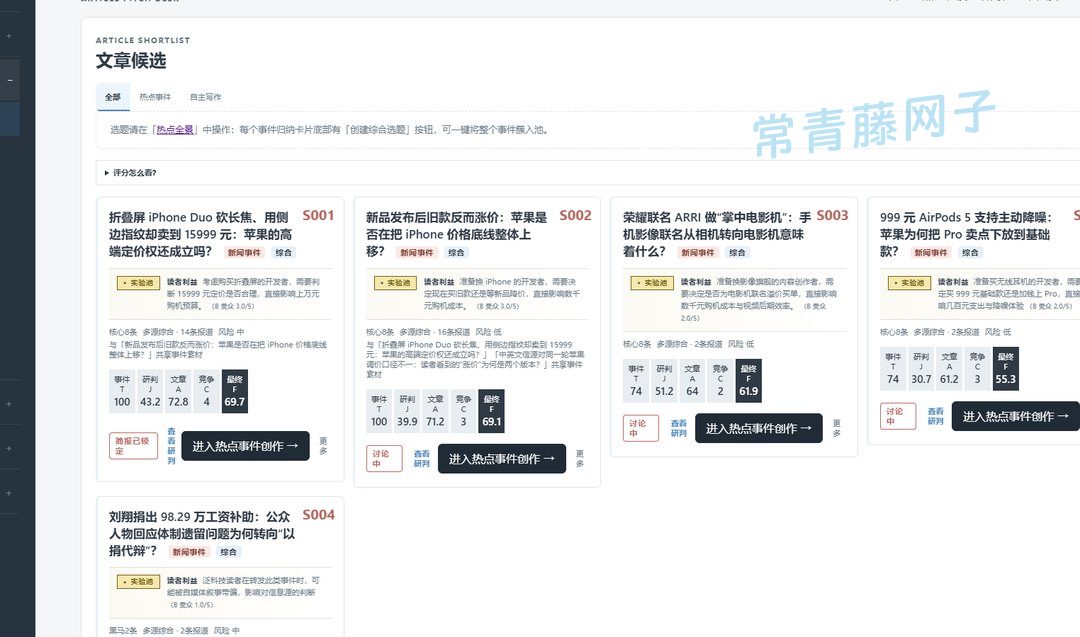
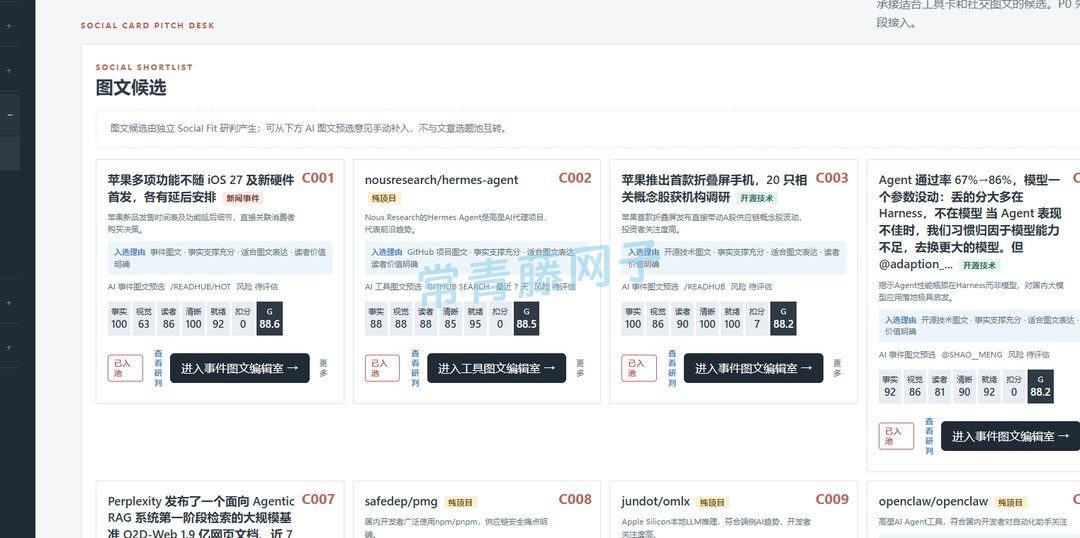
见字接了 RSS、RSSHub、Reddit、GitHub 和网页抓取五个来源,热点自动收进工作区。官方演示批次里,一天收了 29,743 条热点。这不是重点——重点是它没有把这些热点直接砸给你,而是先过三道工序:
事件卡:把零散热点聚合成"事件",每条事件算出 T(时间性)、B(品牌性)、J(竞争性)、F(综合)四个分数。选题池里你能看到"折叠屏 iPhone Duo 用侧边指纹卖 15999,苹果的高端定价权还成立吗?"这样的候选题,旁边摆着综合分 69.7、参与渠道 14 条、风险中等。
数据侦探:分数不是黑箱。每张候选卡上挂着"实验池"标记,写明"读者利益:考虑购买折叠屏的开发者",让你知道这道题是给谁出的。
一次一个关键问题:进入热点事件创作后,它一次只问你一个问题。比如写一篇"不依赖亲测的折叠屏评测",它会先问:你能提供可验证的第一人称经历吗?你要走"全公开事实+市场数据"路线,还是"亲测+证据"路线?选 A 后,所有判断只能基于公开事实,禁用第一人称体验——用门槛把写作路线钉死,防止 AI 顺着惯性滑进"我体验了"这种编不出来的腔调。
二、编辑会的设计:AI 像个会上发言的同事,不是替你写稿的枪手
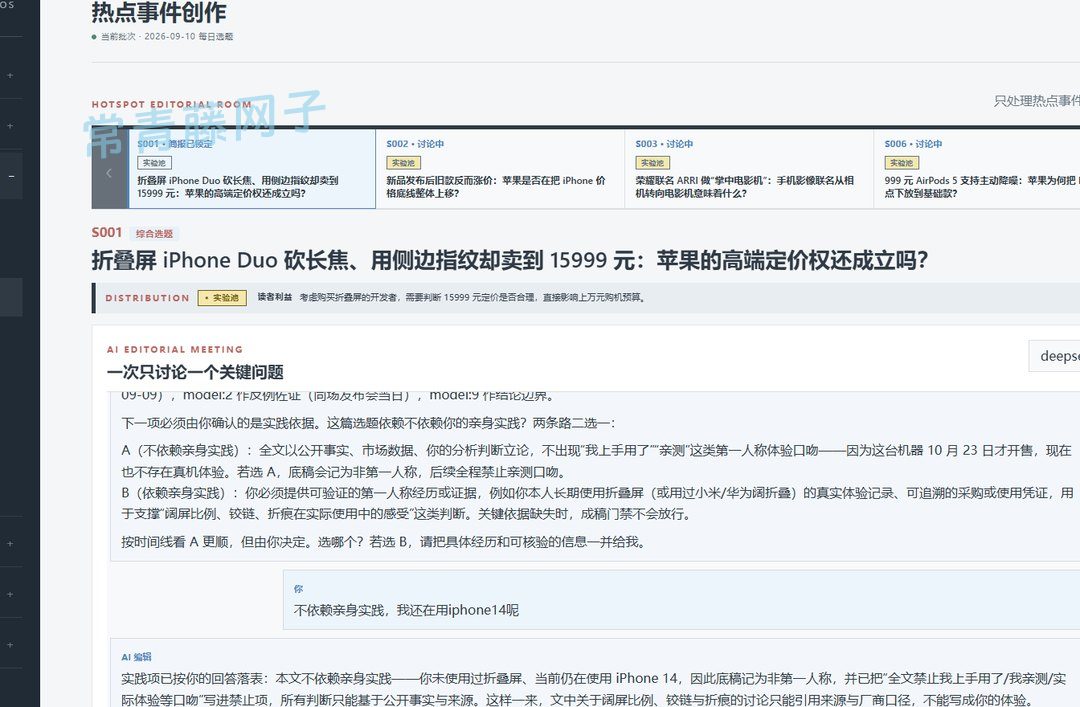
这是整个项目里我觉得最聪明的设计。它不搞"一键生成文章",而是搞"编辑会"——AI 每轮只抛一个决策问题,你回答完它才进下一步。演示截图里能看到这样一段对话:
「下一步必须由你确认的是「实践」这条路线。两条路二选一:A(依赖事实实践)……B(依赖亲身实践):你必须提供可验证的第一人称经历或证据……关键依据缺失时,成稿门禁不会放行。」
你回答"不依赖亲身实践,我还在用 iPhone 14",它会给你回一份"落表":本文不依赖亲身实践——你未使用过折叠屏,因此底稿记为非第一人称,并把"全文禁止上手/亲测/体验"这类字眼写进禁写项,所有判断只能基于公开事实与来源。
这就是编辑会的核心:AI 不替你做决定,它把决定摆到你面前,等你拍板。写稿的路线、立场的边界、哪些话不能说,全在开会时定死,后面成稿阶段只是执行。
三、成稿链是流水线,不是单发炮
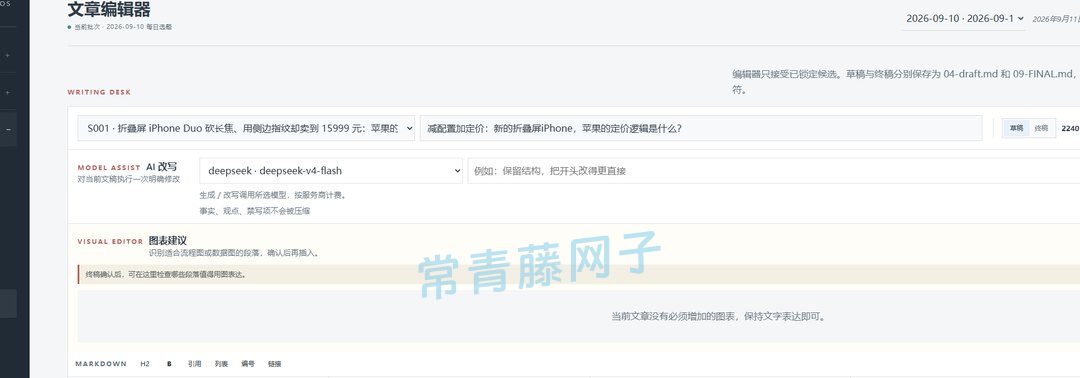
写稿环节分成五个阶段:事实基座、直写、审稿、按需字数调整、标题锁定。每个阶段是独立文件(04-draft.md、09-FINAL.md),版本历史可回看。编辑器左边写稿右边预览,底栏实时显示字数,AI 改写、图表建议、审稿建议都是独立面板,不是把所有功能塞进一个输入框。
有个细节值得说:字数门禁默认是"建议性"的。0.4.0 版本把字数超限从"阻断流程"降级成"记警告、任务照常完成",编辑器保存终稿不再拒绝,只弹提示。这个取舍很成熟——字数超了不该卡死流程,写作者自己心里有数。
四、排版和封面:模板生成,不是文生图

封面走的是"AI 设计规格 + 确定性 HTML 渲染"路线:AI 只产出一份规格 JSON(选主题、组合组件、断行高亮),规格校验不合规就整体回退到 fallback 封面,保证永远出图;最终由本地 Chromium 截图成 900×383 PNG。不用文生图模型,不会出现"画出来的封面字是歪的"这种事故。
排版链分六个阶段:渲染、设计、配图、草稿、规范化、门禁。其中配图环节有意思——AI 不找"现成图片",而是从已采集来源里选:页面本身在手机宽度下能读就截图;数据对比场景就出数据卡,且必须提供来源 ID,流水线会重新抓网页并核对数字同时出现在终稿和来源正文里才生成。防编造是刻在流程里的。
五、它是真的在服务"个人电脑上的生产者"
几个工程细节能看出这不是个玩具:
本地优先:数据全在 SQLite(node:sqlite,无原生编译依赖),服务绑死 127.0.0.1:4317,没有 Web 框架。你写的东西不上任何人的服务器。
安全边界是认真做的:docs/ 里有完整的 threat-model.md,明确写了"确认头只是防误触非鉴权",也写了网页抓取强制拒绝内网地址。这种把自家安全边界写明白的项目不常见。
测试量:仓库里有 298 个测试文件。对一个个人维护的项目来说,这个比例说明作者知道自己在写什么。
版本节奏:从 7 月底的 0.0.1 到 11 月中的 1.0.15,15 个版本节点,CHANGELOG 每条都写得清清楚楚——加了什么、改了什么、修了什么,不糊弄。
六、几个注意事项
- 桌面安装包目前只有 Windows 10/11 x64,macOS 和 Linux 要自己跑源码(实验性支持)。
- 首次启动要下 Node 运行时;源文作者踩过启动脚本后台化的坑,README 里也提了。
- 采集质量取决于你配的源;Reddit 源需要单独 Chrome Profile。
- 它是个人工具,不是多人协作 SaaS,别拿去当团队平台。
写在最后
见字最打动我的一点是:它没有把 AI 当成"替你写文章的魔法",而是当成"跟你开会讨论的同事"。选题有数据有事实,路线由你拍板,边界开会时定死,成稿是流水线不是单发炮。
如果你想找的是"一键生成爆款",它不是;但如果你想把自己的公众号生产从网页缝里收回到一台电脑上,它值得花一个下午装起来。
项目地址:https://github.com/shiker1996/wechat-editroom
— 胡聊八道 · 都是瞎聊 —


 EdgeOne
 ESA